語義層是 AI Agent 的契約載體
語義層並非數據中台的裝飾性模組,而是 AI Agent 與企業數據系統之間可驗證、可追溯、可審計的契約載體。本文剖析其於 NL2SQL、權限對齊與本體建模中的核心作用。
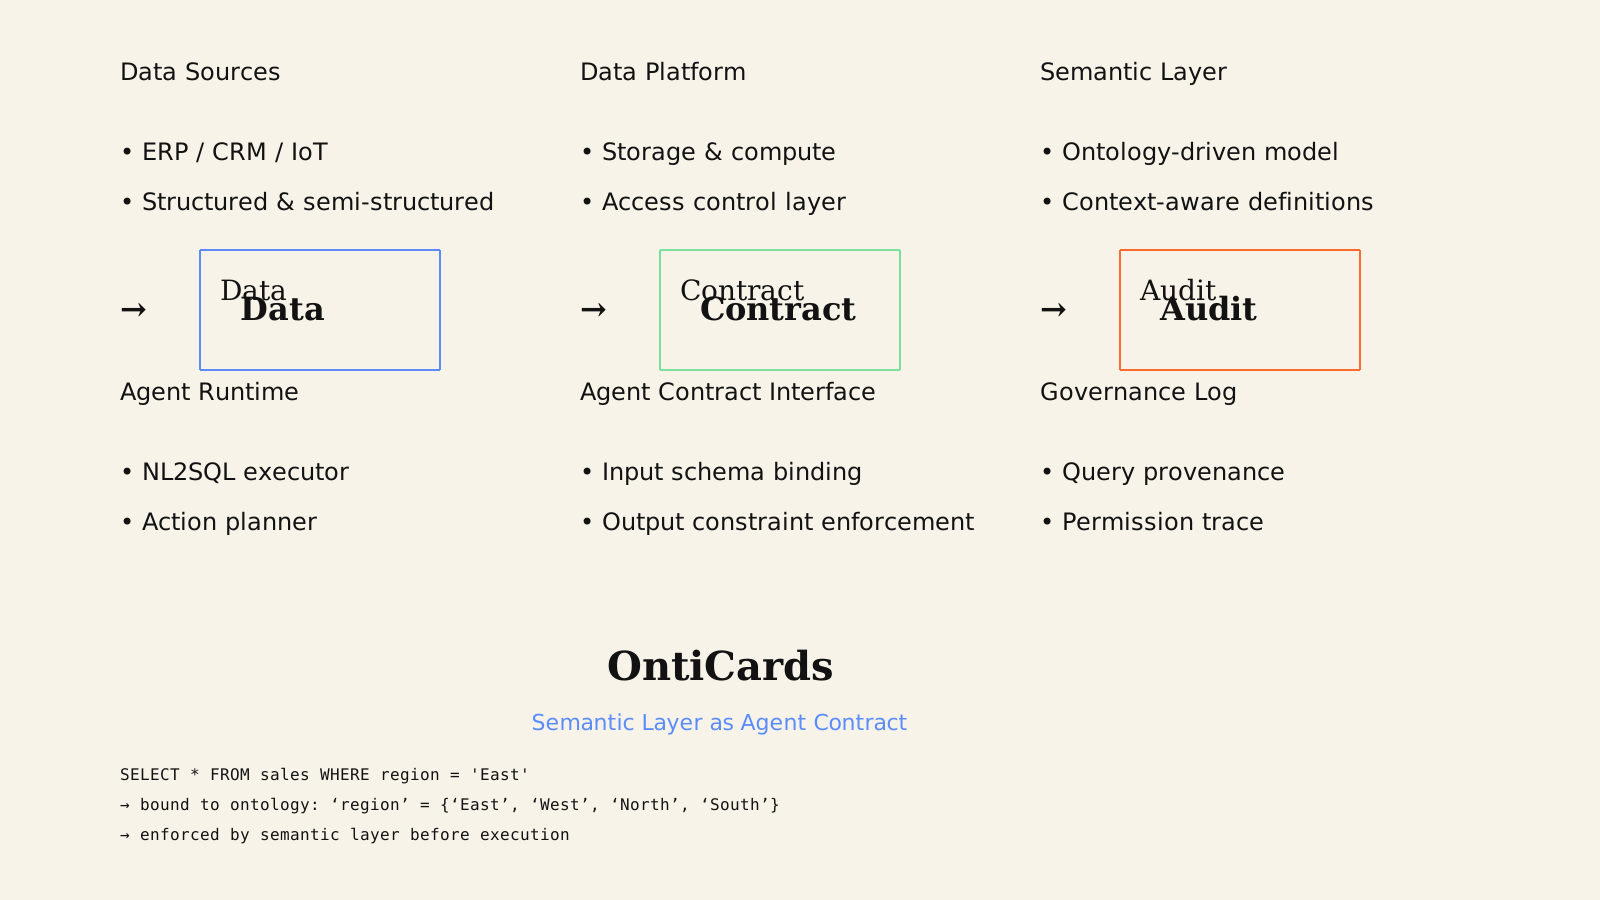
企業部署 AI Agent 後最常遇到的並非能力不足,而是「行為不可控」:同一自然語言請求,在不同時間、由不同 Agent 發起,可能命中不同表格、觸發不同權限邏輯、回傳口徑不一致的結果。問題根源不在模型本身,而在缺乏一套被所有參與方共同承認並強制執行的「數據契約」——語義層正是這一契約的技術具象。
語義層的本質是契約,不是映射
傳統語義層常被簡化為「欄位別名 + 表格關聯」的設定介面。這種理解忽略了其管治本質:它定義了「什麼可以被說、如何被說、誰可以說、結果應為何種形態」。當一個 Agent 提交 NL2SQL 請求時,語義層不是被動翻譯 SQL,而是主動核驗:
- 輸入是否在預先定義的上下文內(例如,「上季」必須綁定至財務日曆而非自然日曆);
- 所涉概念是否存在歧義消解規則(例如,「客戶」於銷售領域指簽約主體,在售後領域則指服務對象);
- 輸出是否符合業務一致性約束(例如,所有營收類指標須經「收入確認準則」核驗)。
這已超出元數據管理範疇,進入契約工程(Contract Engineering)領域。
NL2SQL 的瓶頸不在生成,而在約束注入
現時多數 NL2SQL 方案將優化重心放在模型微調或提示工程上,但真實場景中,準確率的上限往往由語義層決定。例如,在與製造業客戶協作時,常見情況是同一張報表於財務與生產兩套口徑中對不上。此時提升效果的關鍵,不是更換參數量更大的模型,而是將「成本中心歸屬規則」「工單狀態流轉邏輯」等業務知識沉澱為語義層中的約束條件,並於查詢解析階段即介入。
換言之:模型負責「把話說對」,語義層負責「確保話只能這麼被說」。
權限與口徑必須耦合在語義定義中
權限控制若僅靠 RBAC 或列級策略,會面臨「策略漂移」風險:當一張表格新增欄位、一個檢視表重構邏輯、一種新分析情境出現,權限規則未必同步更新。而語義層天然具備上下文感知能力。它可將「可存取性」定義為概念屬性的一部分:
concept: SalesRevenue {
  permission: "finance_team AND (region = 'APAC')"
  validity: "valid_from <= CURRENT_DATE <= valid_to"
}
此類宣告式定義使權限成為數據含義不可分割的部分,而非外掛策略。當 Agent 請求「亞太區上季營收」時,語義層自動完成權限核驗與時間範圍歸一化,無需運行時再查策略引擎。
本體驅動建模:讓契約可推理、可演化
輕量級語義層依賴手動設定,難以應對複雜業務演化。真正支援 Agent 長期可信運作的,是基於本體(Ontology)的建模方式。它不只定義「是什麼」,更表達「為什麼這樣定義」以及「與其他概念的邏輯關係」。
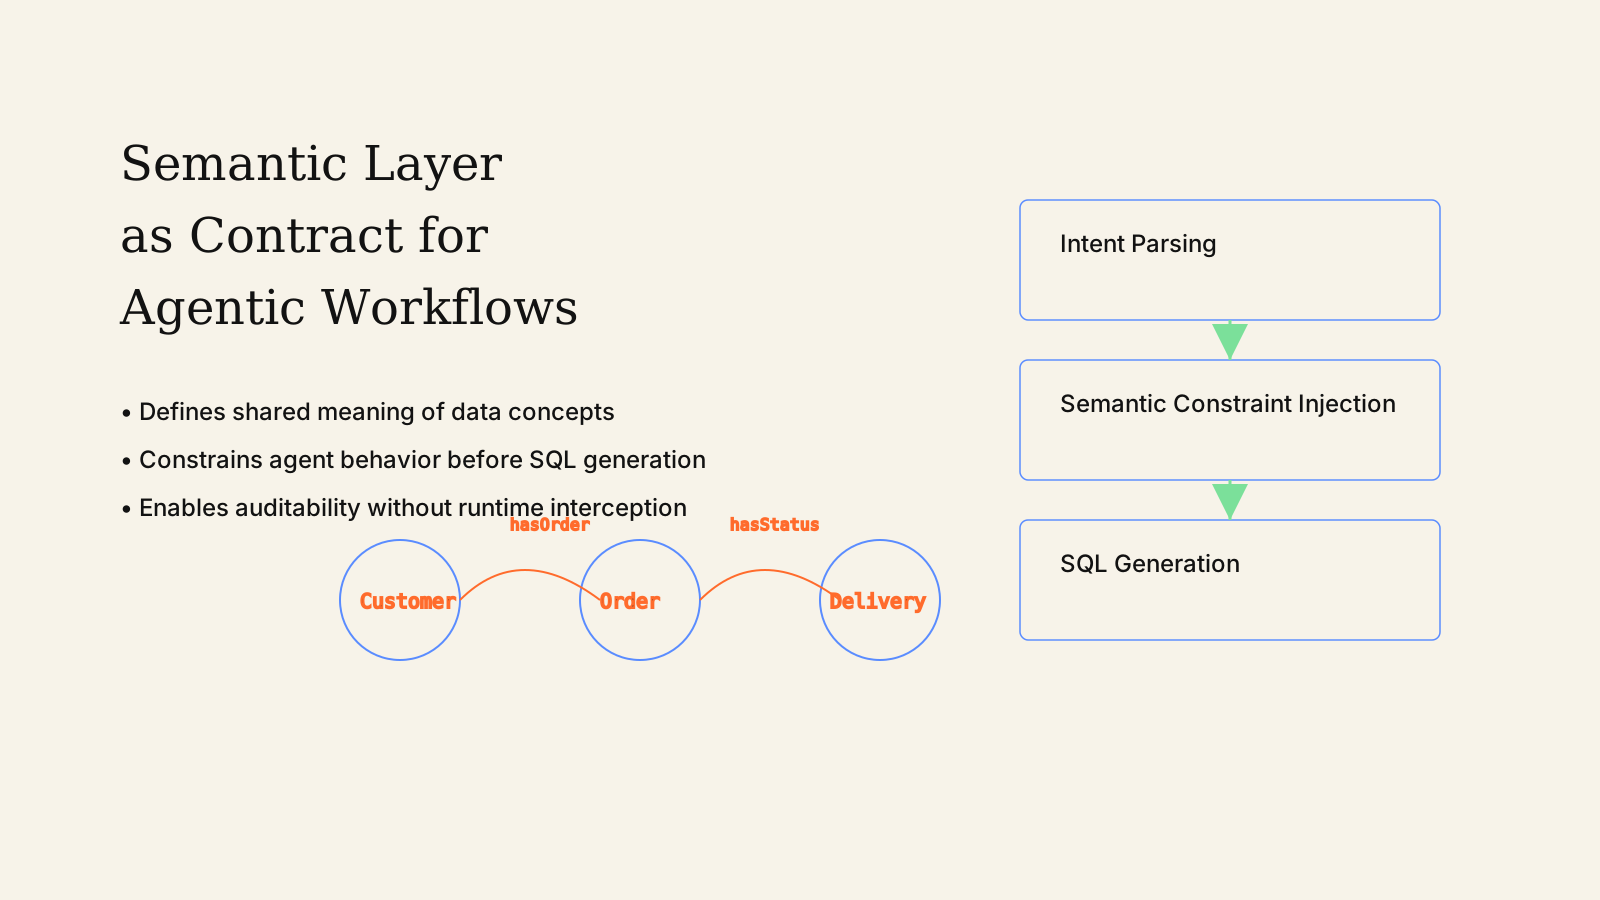
例如,定義 Customer 概念時,不僅標註其來源欄位,還聲明:
isSubClassOf Person
hasRelationship contractWith Company
hasConstraint lifecycleStatus IN {‘Prospect’, ‘Active’, ‘Churned’}
這些邏輯斷言使語義層具備基礎推理能力:當 Agent 查詢「流失客戶關聯的未結清合約數」時,系統可自動推導出需聯合 Customer、Contract 及其狀態約束,而非依賴人工編寫 JOIN 邏輯。
組織落地的關鍵取捨:先契約,後智能
不少團隊試圖「一步到位」:直接訓練 Agent 理解原始數據庫 Schema。結果是模型於測試集表現尚可,上線後因業務變更頻繁導致行為失穩。更穩健的路徑是分兩步走:
- 先固化契約:用語義層收攏數據口徑、權限邊界與業務規則,形成穩定輸入面;
- 再釋放智能:於此之上建構 NL2SQL、Agent 工作流與審計追蹤能力。
這看似降低初期靈活性,實則大幅提升長期可維護性。因為契約一旦確立,後續模型迭代、Agent 升級甚至底層數據平台遷移,都可在語義層隔離變化。
語義層的價值,從來不在它「做了什麼」,而在於它「阻止了什麼」——阻止模糊請求越過業務紅線,阻止權限邏輯與數據定義脫鉤,阻止 AI 行為脫離組織管治框架。它不是數據管線上的其中一個環節,而是人、Agent 與數據系統之間默認簽署的那份沉默協議。
參考來源
- The Semantic Layer Is Not Optional — Sisense Blog, 2023