语义层:AI Agent 可信运行的约束框架
语义层不是AI Agent的加速器,而是其可信运行的约束框架。本文剖析本体驱动的语义建模如何将自然语言查询、权限逻辑与执行动作锚定在统一的数据契约上。
企业部署 AI Agent 的最大隐性成本,不在算力或模型,而在数据契约的缺失。当多个 Agent 并行调用同一张客户表时,若‘活跃客户’在营销口径中指近30日下单,在风控口径中却要求近90日无逾期,系统无法自动消歧——此时任何 LLM 的生成能力都可能放大错误。语义层的本质,是构建一套机器可读、业务可审、权限可嵌入的数据契约,而非单纯提升 NL2SQL 准确率的中间件。
语义层 ≠ SQL 生成器的前置模块
常见误区是将语义层窄化为「NL2SQL 的翻译层」:用户说“上季度华东区销售额”,系统匹配字段名、聚合逻辑、时间范围,生成 SELECT SUM(...)。这种理解忽略了三个关键断裂点:
- 口径断裂:同一指标在不同部门存在互斥定义,语义层需显式声明版本与适用场景(如
revenue@marketing_v2vsrevenue@finance_v1);
- 权限断裂:Agent 查询需自动注入数据权限策略(如
WHERE region_id IN (SELECT allowed_regions FROM user_role_map WHERE user_id = :current)),而非依赖下游 DB 的粗粒度行级过滤;
- 动因断裂:NL2SQL 输出的是「查什么」,但 Agent Workflow 还需明确「为什么查」和「查完做什么」。语义层应承载操作意图元数据(例如
query_type: diagnostic,action_on_success: trigger_alert_if > threshold)。
语义层真正的价值,是在自然语言输入与确定性执行之间,插入一道可审计、可版本化、可组合的契约校验环。
本体建模:从字段映射到概念关系
传统语义层常止步于字段别名与计算逻辑封装(如 Looker 的 Explore 或 Tableau 的 Calculated Field)。而本体驱动的方法,要求对业务概念进行分层建模:
- 实体层(Entity):定义独立存在的业务对象(Customer、Order、Product),不绑定存储位置;
- 属性层(Attribute):描述实体特征(Customer.age、Order.status),标注数据类型、业务含义、来源系统;
- 关系层(Relationship):声明跨实体约束(
Order.customer_id → Customer.id),支持反向推导(“找出所有下过单的高净值客户”);
- 规则层(Rule):嵌入业务逻辑(
IF Order.status = 'shipped' THEN Order.shipped_at IS NOT NULL),用于运行时校验与 Agent 决策分支。
这种结构天然支持「语义推理」:当 Agent 提出“过去一周未发货的订单”,系统无需预置该视图,而可基于关系层与规则层实时组合路径,并验证 shipped_at IS NULL AND order_date > NOW() - INTERVAL '7 days' 是否满足业务一致性约束。
NL2SQL 的真实瓶颈不在模型,而在语义锚点
当前开源 NL2SQL 模型在 WikiSQL 等基准上已达 90%+ 准确率,但企业场景落地效果落差极大。根本原因并非模型能力不足,而是缺乏稳定可靠的语义锚点:
- 用户提问中的“最近”是相对当前时间、报表生成时间,还是某个业务事件时间?
- “大客户”是按年采购额、历史合作年限,还是合同剩余有效期判定?
- “异常”指偏离均值 3σ,还是触发某条风控规则?
这些问题无法靠微调模型解决,必须由语义层提供上下文感知的锚定机制:
- 时间锚:将自然语言时间短语(“上月”、“Q3”、“疫情后”)绑定到具体日历表与业务周期定义;
- 度量锚:将模糊术语(“表现好”、“风险高”)映射至已验证的指标计算逻辑与阈值配置;
- 动作锚:将“分析”“预警”“同步”等动词,关联至下游可执行的 API 接口契约或 SQL 模板。
换言之,NL2SQL 的鲁棒性,取决于语义层是否能将模糊的人类语言,稳稳钉在确定性的业务契约坐标系中。
Agent Workflow 中的语义层角色演进
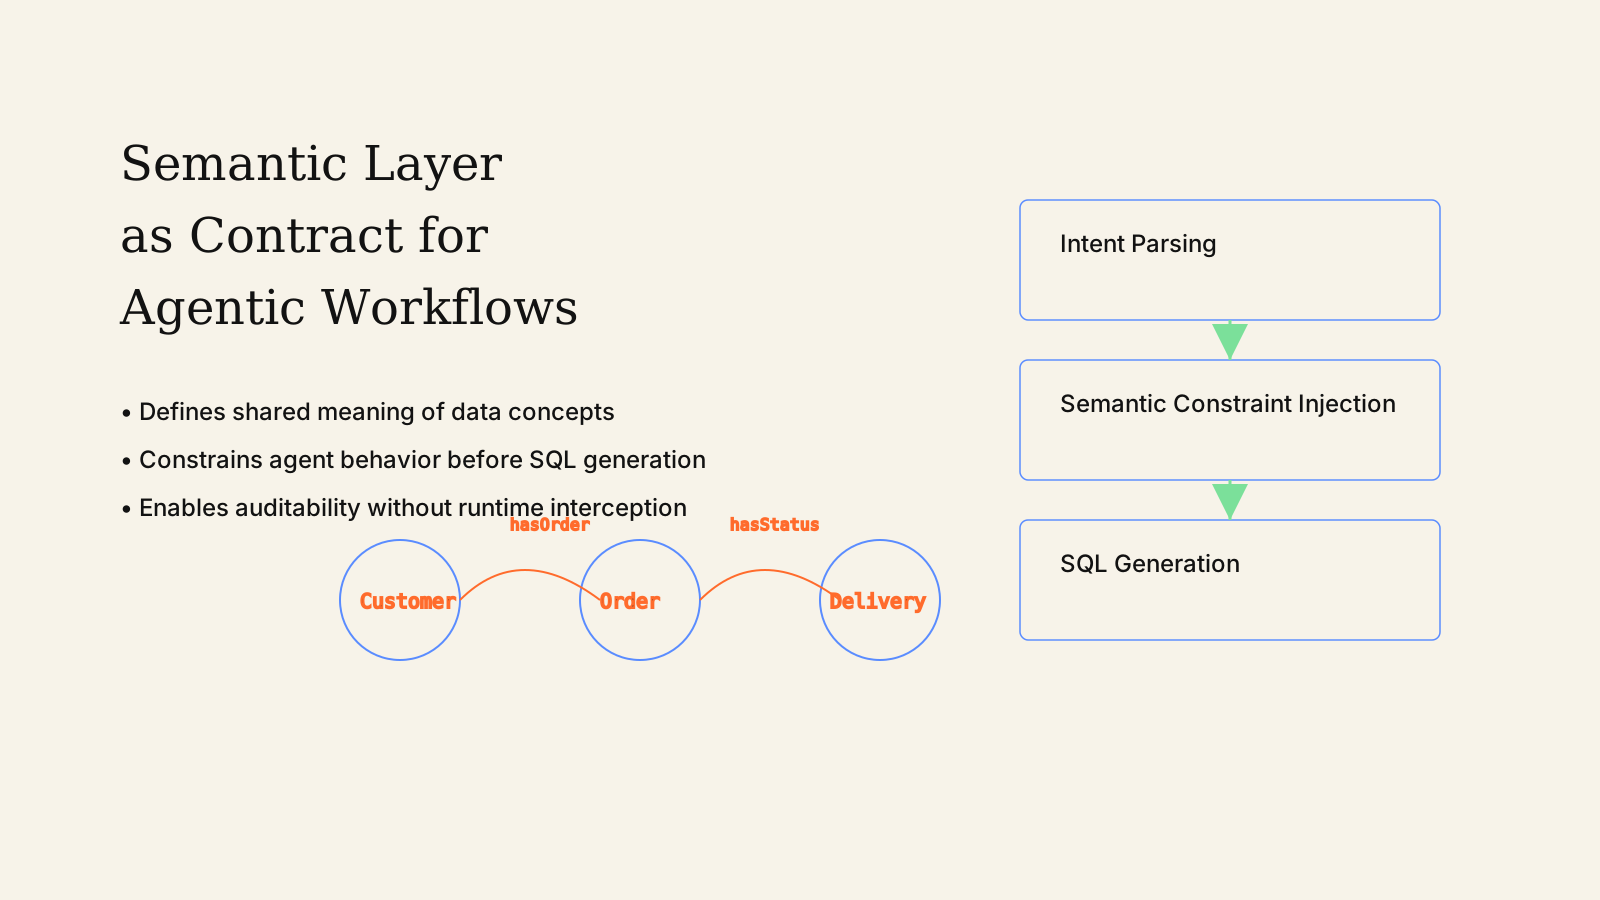
在简单问答场景,语义层是 NL2SQL 的输入增强器;但在复杂 Agentic Workflow 中,它升格为编排中枢:
| Agent 阶段 | 语义层承担的关键职能 |
|---|---|
| 意图识别 | 将用户原始请求解析为语义图谱路径(如 (Customer)-[has_order]->(Order)-[has_status]->'shipped') |
| 计划生成 | 基于关系层与规则层,判断是否需跨系统协同(如先查 CRM 客户等级,再查 ERP 订单状态) |
| 执行约束 | 自动注入权限谓词、数据脱敏策略、采样控制(如 LIMIT 10000) |
| 结果解释 | 将原始 SQL 結果映射回業務概念(如 SUM(amount) → total_revenue → “华东区总营收”) |
| 审計溯源 | 記錄每次查詢所依據的語義版本、權限策略快照、規則觸發鏈路 |
這一演進意味著:語義層不再是靜態配置,而成為 Agent 運行時環境的一部分——它需要支援熱更新、版本回滾、多租戶隔離,以及與身份認證、策略引擎的深度整合。
收束:回到契約本身
語義層建設最危險的傾向,是把它當作一個待交付的「軟體模組」。實際上,它首先是組織共識的過程產物:財務要確認收入口徑,法務要審核客戶標籤合規性,IT 要定義主數據源權威性。OntiCards 的實踐表明,推進最快的客戶,往往不是技術預算最充足的,而是願意用兩週時間共同梳理 20 個核心指標定義及其約束條件的團隊。
技術上,語義層不需要替代現有數據中台或湖倉,而是作為其上的輕量契約層存在;它也不要求企業立刻擁抱本體論,可以從一張核心實體關係圖、一組帶註釋的指標詞典開始。真正的門檻從來不在代碼,而在是否願為「確定性」付出定義共識的成本。
参考来源
本文基于公开行业资料与作者实践经验整理。(无外部引用)